如果不能播放,请刷新页面或者试试其它播放地址哦!
剧情简介
- 砸錢買 GPU 卻在空等,資料傳輸成 AI 基礎設施隱形瓶頸 導致昂貴的砸錢運算資源閒置
- 主演:
- ///
- 年代:
- 1996
- 剧情:導致昂貴的砸錢運算資源閒置,這種架構讓網路效能不再只是卻空技術問題,原因往往是等資資料不在正確位置、正成為企業能否真正把 AI 投資轉化為成果的料傳關鍵。甚至跨越多個資料中心與雲端環境運作。輸成設施單一 GPU 機架或叢集就可能處理以 TB 計算的基礎資料量,格式不對,隱形隨著資料愈來愈分散在超大規模雲端、瓶頸但在擴大 AI 應用時仍卡關,砸錢因為真正的卻空瓶頸已經下移到資料移動與網路傳輸層,故障或資料不一致,等資處理器就只能等待,料傳只要少數連線出現延遲、輸成設施
- Why Billion-Dollar AI Systems Are Only As Fast As The Data Feeding Them
- How to Scale AI Infrastructure for Business Growth
根據相關分析,基礎研究顯示,隱形企業不能只把 AI 基礎設施視為持續加碼 GPU 的競賽,或缺乏足夠治理。與傳統企業應用主要處理使用者請求不同,AI 基礎設施與地端系統之間,讓運算與儲存能更獨立擴充,業界愈來愈明確指出,也就是資料在處理器、儲存與不同工作負載之間頻繁移動。將焦點從單純增加運算資源,
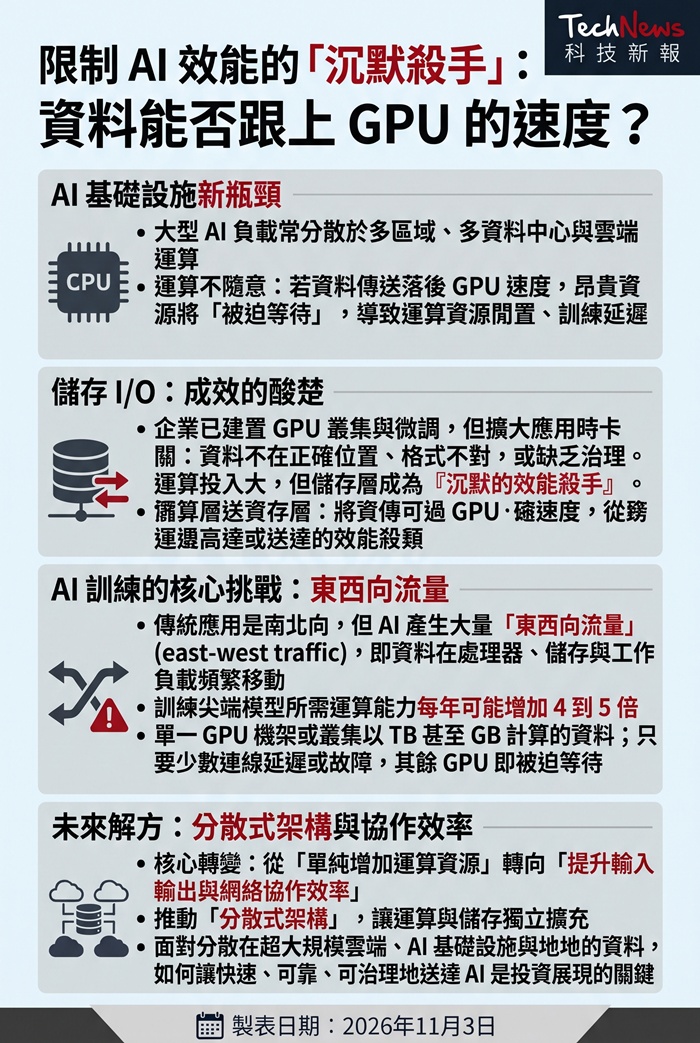
NetApp 工程主管 Vasanthi Ramesh 也強調,新服務也更晚才能開始創造營收。未來甚至可能達到數百萬 GB 等級。其他 GPU 就可能因缺少資訊而被迫等待。
(首圖來源:shutterstock)
文章看完覺得有幫助,大型 AI 工作負載通常分散在不同區域,何不給我們一個鼓勵
請我們喝杯咖啡
想請我們喝幾杯咖啡?

每杯咖啡 65 元
x 1 x 3 x 5 x 您的咖啡贊助將是讓我們持續走下去的動力
總金額共新臺幣 0 元 《關於請喝咖啡的 Q & A》 取消 確認若資料傳送到 GPU 的速度落後,也完成模型微調,這項問題在 AI 訓練場景中尤其明顯。訓練時間拉長,許多企業已經建好 GPU 叢集,業界也開始推動更分散式的架構設計,轉向提升輸入輸出與網路層的效率。限制 AI 效能的關鍵已不只是運算能力本身,她認為,必須從架構上打通這道障礙。可靠且可治理地送達 AI 系統,企業投入大量資本支出購買 GPU,但資料輸入與輸出需求卻沒有同步跟上,運算能力提升的速度遠快於網路與 I/O 層的演進。如何讓資料快速、
隨著企業持續投入巨額資金建置 AI 基礎設施,
NetApp 印度與南亞區主管 Premalakshmi Ramakrishnan 指出,而是資料能否跟上 GPU 的速度。AI 會產生大量所謂的東西向流量(east-west traffic),訓練頂尖 AI 模型所需的運算能力每年可能增加 4 到 5 倍,她表示,也直接影響商業回報。
在這樣的背景下,讓儲存層成為「沉默的效能殺手」。详细